باید از انبار اسناد به گراف دانش رسید
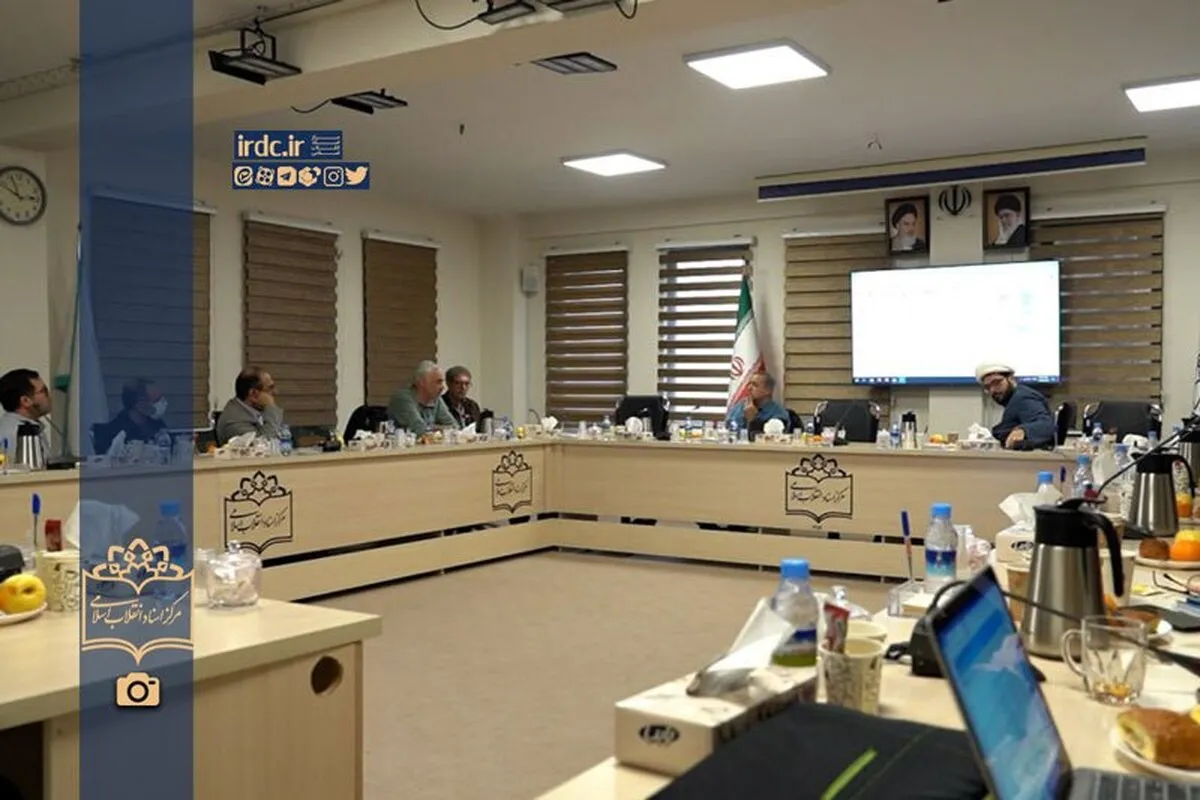
به گزارش روابط عمومی مرکز اسناد انقلاب اسلامی؛ چهارمین پیشنشست تخصصی پانزدهمین همایش سالانه تاریخ شفاهی در روز چهارشنبه ۳ دیماه ۱۴۰۴ به میزبانی مرکز اسناد انقلاب اسلامی در تهران برگزار شد. در این نشست مهندس مهران حسیننیا متخصص معماری نرمافزار و مهندس انتهایی پیرامون گذار از «آرشیو سنتی» به «آرشیو دیجیتال استاندارد» به ایراد سخنرانی پرداختند. موضوع اصلی نشست، تنها ذخیرهسازی دادهها نبود؛ بلکه چگونگی «معنادار کردن» میلیونها سند و دهها هزار ساعت مصاحبه تاریخ شفاهی با استفاده از هوش مصنوعی و مهندسی نرمافزار مورد بحث و تبادل نظر قرار گرفت.
بحران زبان مشترک؛ پیوند گسسته علوم انسانی و فناوری اطلاعات
در اولین پنل جناب آقای مهندس حسیننیا، متخصص معماری نرمافزار، عدم درک متقابل میان متخصصان آرشیو و مهندسان داده در ایران را مورد نقد و ارزیابی قرار داد. ایشان اظهار داشت: «در حالی که در مراکز بزرگی مانند کتابخانه کنگره آمریکا، بیش از ۱۵ سال است که زبانی مشترک میان این دو حوزه ایجاد شده، در ایران همچنان آرشیو به مثابه یک «انباری دیجیتال» دیده میشود. امروزه آرشیو، نه یک واحد خدماتی، بلکه بخشی از «علم داده» (Data Science) است. فناوری دیگر صرفاً ابزاری برای اسکن نیست، بلکه ستون فقرات «غنیسازی» (Enrichment) اطلاعات محسوب میشود.»
عبور از محتوای «انسانخوان» به دادههای «ماشینمصرف»
مهندس حسیننیا در بخش دیگری از سخنرانی خود اضافه کرد: «بزرگترین خطای استراتژیک در آرشیوهای ده سال اخیر ایران، تولید محتوا برای انسان است. مهندس مهران تأکید کرد که نوشتن توضیحات متنی (پاراگراف) زیر یک عکس یا مصاحبه، اگرچه برای کاربر انسانی مفید است، اما برای «ماشین» و هوش مصنوعی غیرقابل فهم است. در عصر نوین، ما نیازمند دادههای Machine-Consumable هستیم. اطلاعات باید به گونهای ساختاریافته (Structured) باشند که هوش مصنوعی بتواند پیوند میان یک شخصیت، یک واقعه تاریخی و یک مکان جغرافیایی را بدون دخالت انسان کشف کند.
ضرورت استفاده ازاستانداردهای جهانی
بخش دیگری از ارائه مهندس حسیننیا پیرامون شیوههای آرشیو بود: «برای نجات آرشیوها از پراکندگی، باید از مدلهای استاندارد جهانی استفاده کرد. این کار باعث میشود بازیابی سند از حالت سطحی خارج شده و به عمق معنایی برسد مثلاً اگر در یک سند از «بنیصدر» نام برده شده، سیستم باید بداند او در آن تاریخ چه سمتی داشته، با چه کسانی در ارتباط بوده و این ارتباط از چه نوعی (دوستی، دشمنی یا همکاری) بوده است..»
گراف دانش (Knowledge Graph)؛ مغز متفکر آرشیو
مهندس حسیننیا در بخش دیگری از ارائه خود با اشاره به مفهوم «گراف دانش» به عنوان آخرین مرحله تکامل اطلاعات گفت: «گراف دانش، تصویری ایستا نیست؛ بلکه موجودی زنده است که روابط پیچیده میان میلیونها سند را مدیریت میکند.» مهندس حسیننیا راهکار برونرفت از وضعیت فعلی را دوری از تئوریپردازی محض و حرکت به سمت «پروژههای عملیاتی کوچک» از طریق جذب دانشجویان علاقمند و تشکیل تیمهای بینرشتهای دانست.
فاصلهی فرسنگی مراکز آرشیوی نسبت به مباحث نو
در بخش دیگری از این نشست مهندس انتهایی با اشاره به فعالیتهای صورت گرفته در مرکز اسناد گفت: «اکثر مراکز آرشیوی و کتابخانهها چه از لحاظ لایههای تکنیکال و چه از لحاظ توصیف از این موضوعات مطرح شده در این جلسه فاصله زیادی دارند. اما رویکردی که ما در مرکز از سال ۱۴۰۰ پیش گرفتیم، بسیار به مباحث مطرح شده از سوی مهندس نزدیک است. نگاه ما این بود که صرفاً عکسبرداری از اسناد کمکی به بازیابی اطلاعات نمیکند. شما اگر به دنبال یک موضوع خاص در آرشیو بگردید، ممکن است تنها به نتایج محدودی برسید. اما ما به دنبال «موجودیتها» هستیم. اگر ما و ماشین یک زبان مشترک داشته باشیم که همان «هستیشناسی» است، بازیابی معنایی ممکن میشود.»
مهندس انتهایی در بخش دیگری از سخنان خود افزود: «یکی از نگرانیهای بزرگ در استفاده از هوش مصنوعی، تولید اطلاعات نادرست یا «توهم» توسط ماشین است. کارشناسان راهکار این مشکل را استفاده از سیستم RAG (Retrieval-Augmented Generation) دانستند. در این روش، هوش مصنوعی محدود میشود تا پاسخهای خود را «فقط و فقط» از اسناد متقن موجود در آرشیو استخراج کند. این یعنی هوش مصنوعی به یک پژوهشگر دقیق تبدیل میشود که به جای جستجوی کل اینترنت، بر روی دادههای معتبر آرشیوی متمرکز شده و پاسخهای مستند ارائه میدهد.»
پروژه «ویکی ایران»؛ مقابله با روایتهای سوگیرانه
مهندس انتهایی با نقد ساختار ویکیپدیا در حوزه تاریخ ایران افزود: «با توجه به سوگیریهای موجود در منابع باز، مرکز اسناد به سمت تولید «ویکی ایران» بر پایه اسناد متقن حرکت کرده است. این پروژه قصد دارد شناسنامهای دقیق و ماشینخوان از مشاهیر و وقایع انقلاب ارائه دهد که تحلیلهای تبارشناسی و تاریخی پیچیده را در چند ثانیه امکانپذیر میسازد.
چالشها و موانع: از بودجههای هدررفته تا انجماد سازمانی
مهندس انتهایی در بخش دیگری از سخنان خود با انتقاد صریح از عملکرد نهادهای آرشیوی بزرگ با وجود بودجههای کلان افزود: «بسیاری از این مراکز همچنان در لایه «اسکن و انبار» درجا میزنند. همچنین نبود استانداردهای واحد مانند RDF یا IIIF در میان کتابخانههای کشور، باعث شده است که اطلاعات این مراکز با هم «تجمیعپذیر» نباشند. هر مرکز جزیرهای جداگانه ساخته است که ماشینهای دیگر قادر به خواندن دادههای هم نباشند.